
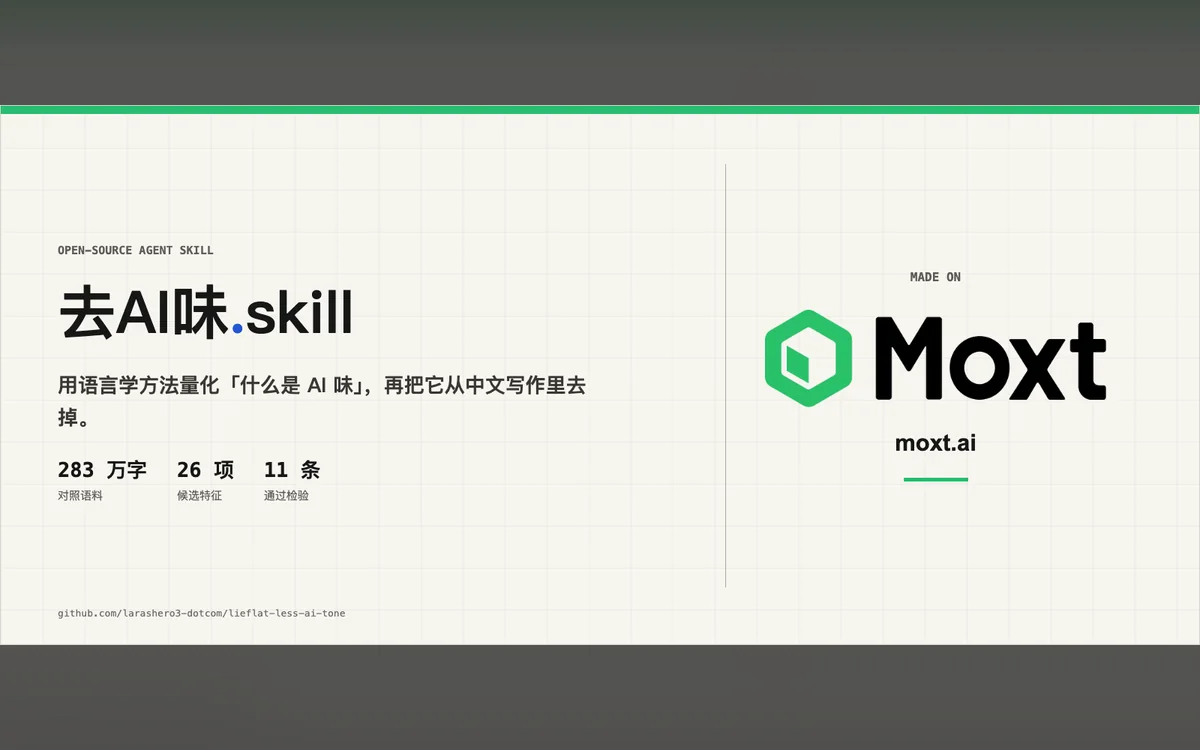
lieflat-less-ai-tone(去 AI 味.skill)由 larashero3-dotcom 维护,在 moxt.ai 制作。它先用语料统计检验“AI 味”到底由哪些特征构成,再把通过检验的部分写成改写规则。和常见的“删破折号、删设问”清单不同,每条规则都能对应到频率比和可复算脚本。按官方 README 整理,未在本机完整实测。
283 万字语料换来的几个结论
研究构建了 629 篇文章的对照语料,共 2,826,972 个汉字、95,551 句、45,721 段。其中 300 篇由五个模型在受控条件下生成,329 篇来自人类作者。候选特征有 26 项,最终只有 11 项通过区分度检验,区分力最强的是“段首零回指评论”,生成侧频率是人类的 4.4 倍。
几项流行判断被数据推翻:人类使用比喻的频率是生成文本的 2.4 倍,正文设问句是 17 倍。也就是说,机械地删掉设问,反而会让文本更像机器写的。模型之间的差异也很大,破折号在 DeepSeek 每千字 5.16 次、Claude 4.25 次、GPT 0.11 次,极差约四十倍,不存在单一的“AI 文风”。
这些数字来自项目自己的语料与算子,README 也承认语料因版权和隐私不公开,第三方无法直接复核。
规则只做 11 件事
通过检验的特征集中在篇章和结构层:对举结构、顿号并列过密、相邻句结构同构、破折号、冒号滥用、序数词充当小标题、拟人化喻体、概括表述覆盖已有数据、起首语、五类译文句式,以及段首零回指评论。
改写时有三重约束。第一是白名单:只处理这 11 项,没命中的句子逐字保留,标题层级、段落次序、列表、表格和代码块位置都不动。第二是信息守恒:不得新增姓名、数字、日期、引语、来源或因果关系,也不得删除原文的观点、结论和限定成分;把“可能提升”改成“提升”算篡改判断强度,不算风格清理。第三是排除语义判断:比喻是否贴切、设问是否必要、案例是否堆砌,这些都无法写成可执行算子,一律不做。
规则全文在仓库的 SKILL.md 里,算子定义在脚本开头,方便逐条核对。
安装与两种使用方式
通过 Agent Skills 安装:
npx skills add larashero3-dotcom/lieflat-less-ai-tone |
也可以直接在 MoxtHub 打开这个 Skill,借助 Moxt 的长上下文空间处理长文;不想装工具时,把 SKILL.md 当 system prompt 粘贴到支持自定义指令的模型里也能用。
同作者的 writing-dna-skill 与本规则集是两道工序:前者负责风格逼近,后者负责清除生成痕迹。如果目录里已经有蒸馏产物 语言DNA.md,会优先读取它;两者冲突时以蒸馏产物为准,因为那记录的是目标作者的实际写法。
复算而不是只读结论
仓库提供三个脚本,分别覆盖句层、段落层和译文句式:
python3 scripts/compare-human-ai.py --human <目录...> --ai <目录...> |
脚本只读取目录里的 .md 文件,不附带语料,也不拿目录名当输出标签。换成自己的语料就能复算指标;如果结论对不上,README 建议先检查话题与文体是否对齐、分母是否匹配被测单位。
一个长文润色场景
一篇四千字的博客初稿,事实、引语和数字都已核对。跑一遍规则集,预期只改命中项:把“不是 A 而是 B”的对举拆开,补上段首缺失的指代,删掉空转的冒号列表,保留原有论据和限定。修改后逐段对照,确认没有新增事实、没有把推测写成结论、没有为了“像人”而加口头禅或错别字。
合同、论文、法规这类文本不适合用它做主要润色。术语、格式和引用规范比文风重要,规则集也不处理这些。
与“去 AI 味提示词”和风格蒸馏的分工
网上流传的提示词清单往往要求删除破折号、设问和比喻;这项研究显示,至少设问和比喻在人类写作中更常见,照单全删可能适得其反。writing-dna-skill 解决“像谁写”,本规则集解决“哪里像模型写的”,顺序是先逼近风格,再清除痕迹。
绕过 AI 检测不是它的用途。改写不会改变使用 AI 的事实,需要披露的场景仍然要披露。
方法和使用边界
语料不公开,结论无法被第三方完整复现;人类侧样本规模有限,生成侧与人类侧的话题也没有严格配对;结论有时效性,模型迭代会改变频率;语义层的问题超出正则算子的能力。README 还记录了六次因算子覆盖过宽导致的测量失误,其中两项初测方向与修正后相反,这部分比结论本身更值得读。
规则能降低某些生成痕迹,但不能保证文本质量,也不能保证事实正确。信息守恒是约束,不是自动校验。
项目入口
- 仓库与规则集:larashero3-dotcom/lieflat-less-ai-tone
- MoxtHub:去 AI 味.skill
- 许可:以仓库为准
- 适合:中文长文作者、编辑、品牌文案,以及想先看证据再决定怎么改的人